生成和发布是两种权限
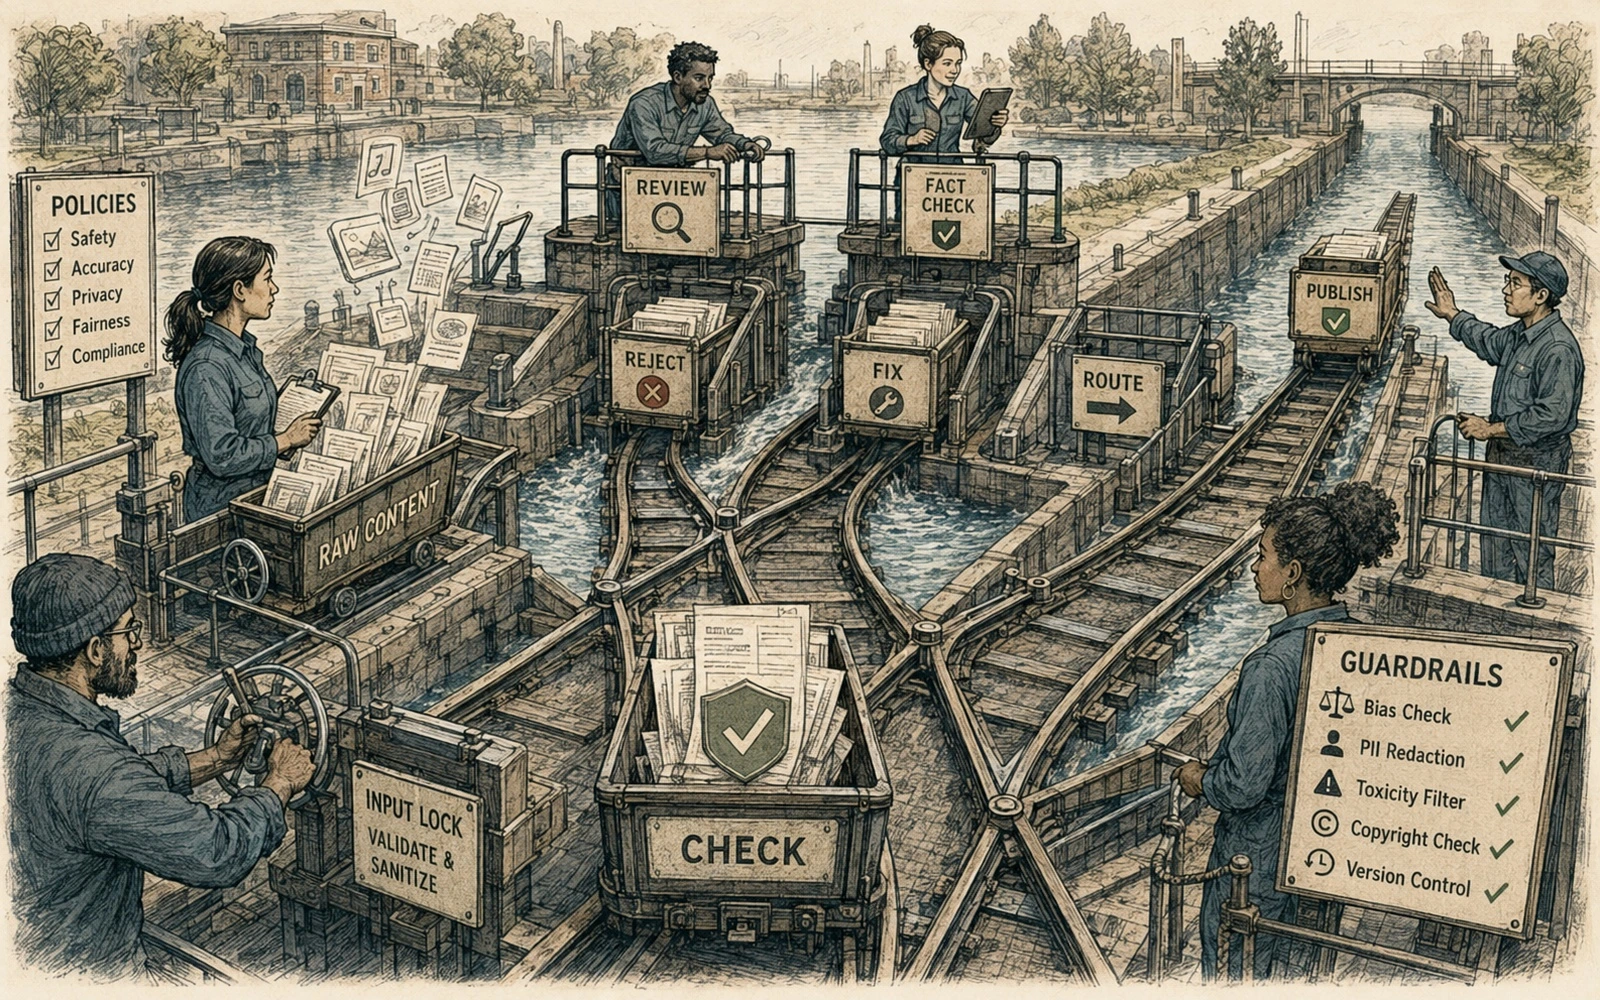
好的架构预设模型有时会错。可以让模型提出文件、元数据和修改,但不要让同一步骤静默发布。独立的 build 和 review 边界可以让失败被看见并可回滚。
批量越大,这条边界越重要。
限制输入集合
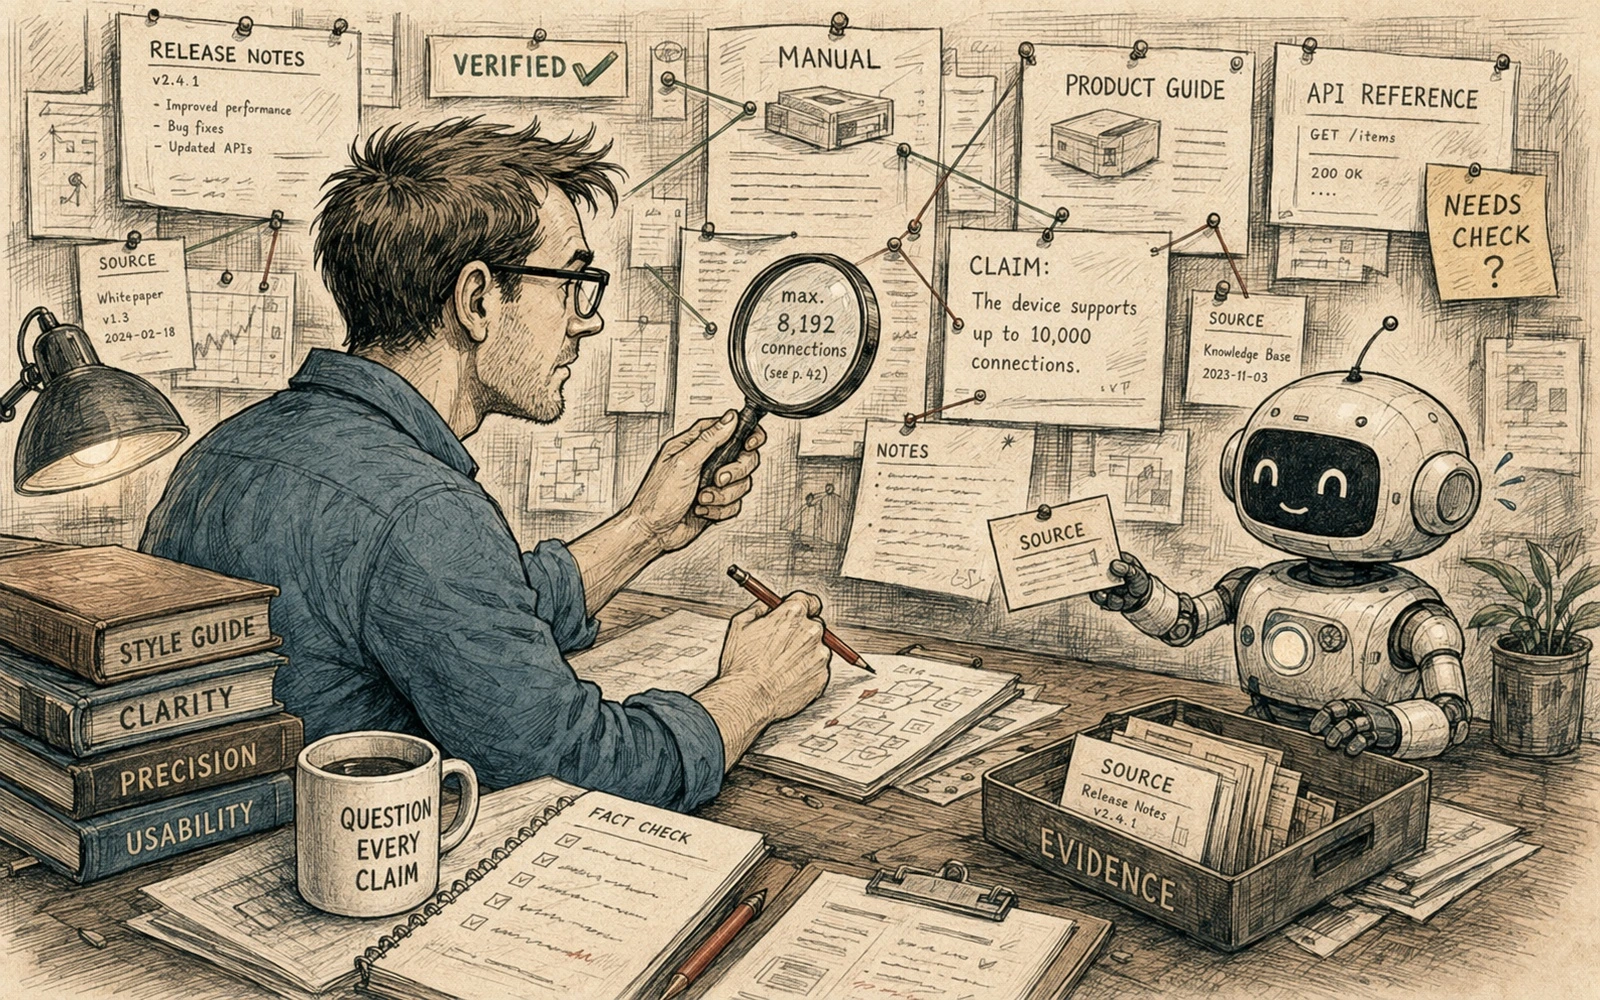
给模型明确命名的来源,而不是无限上下文。把权威产品事实、示例、历史讨论和用户内容分开,并记录某个 revision 使用了哪些文件或 API response。
这让复现和 review 都更容易。
用确定性规则验证结构
frontmatter 使用 schema,tag 和术语使用受控词表,code block 使用 parser。先检查内部 link、图片、本地化完整性和元数据,再进行任何模型层面的 review。
确定性检查应该快速失败,不要浪费模型来判断必填字段是否存在。
把外部文本当作不可信输入
Issue、论坛、网页和客户消息可能包含与发布无关甚至恶意的指令。可以从中提取事实,但不能让这些文字重写 agent rules 或发布策略。
风险声明必须有证据
安全、限制、兼容性、billing、数据处理和破坏性步骤需要更强 review,即使生成文本看起来非常优秀。
保留回滚
每个自动变化都应是普通的 version-controlled revision,有清晰 diff。不要让 pipeline 在没有 commit 或可追踪 artifact 的情况下直接修改线上内容。
护栏的意义,是让吞吐量提升和责任不下降同时成立。
实践示例
在把《面向技术文档发布的 LLM 内容流水线护栏》变成生产流程之前,先用受控样本测试。选择十段你已经知道正确状态的文档:有正确的、过时的、含糊的,也有故意设置错误的。保持指令不变,同时记录正确判断和自信但错误的判断。
按编辑审阅方式检查:
- 模型是否区分证据与推断;
- 是否保持术语和产品约束;
- 是否编造缺失事实或掩盖不确定性;
- 人类审阅者能否看清改了什么以及为什么。
真正重要的不是文字是否流畅,而是流程能否在发布前让错误显现。明确的边界、输入和人工审阅点,才是自动化值得信任的基础。
快速编辑检查
- 生成和发布是两种权限. 好的架构预设模型有时会错。可以让模型提出文件、元数据和修改,但不要让同一步骤静默发布。
- 限制输入集合. 给模型明确命名的来源,而不是无限上下文。把权威产品事实、示例、历史讨论和用户内容分开,并记录某个 revision 使用了哪些文件或 API response。
- 用确定性规则验证结构. frontmatter 使用 schema,tag 和术语使用受控词表,code block 使用 parser。
- 把外部文本当作不可信输入. Issue、论坛、网页和客户消息可能包含与发布无关甚至恶意的指令。