Генерация и публикация — разные привилегии
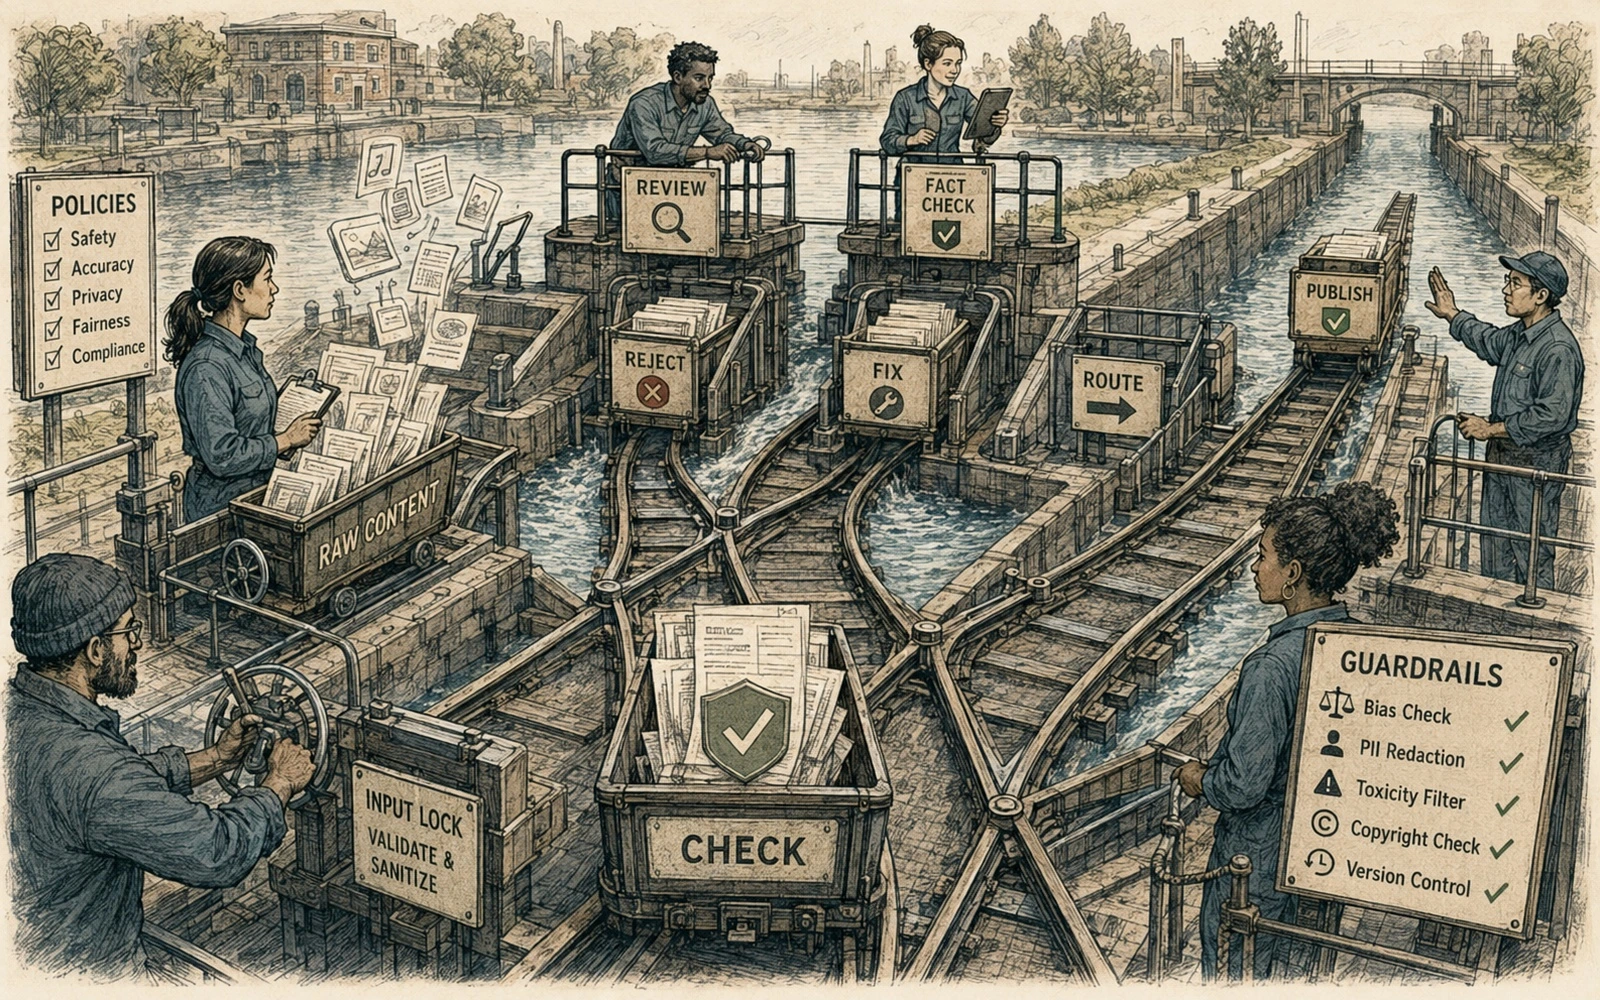
Полезная архитектура заранее предполагает, что модель иногда ошибается. Разрешите ей предлагать файлы, метаданные и изменения, но не позволяйте тому же шагу незаметно публиковать результат. Отдельная граница сборки и ревью делает сбои наблюдаемыми и обратимыми.
Чем больше пакет изменений, тем важнее эта граница.
Ограничивайте набор входных данных
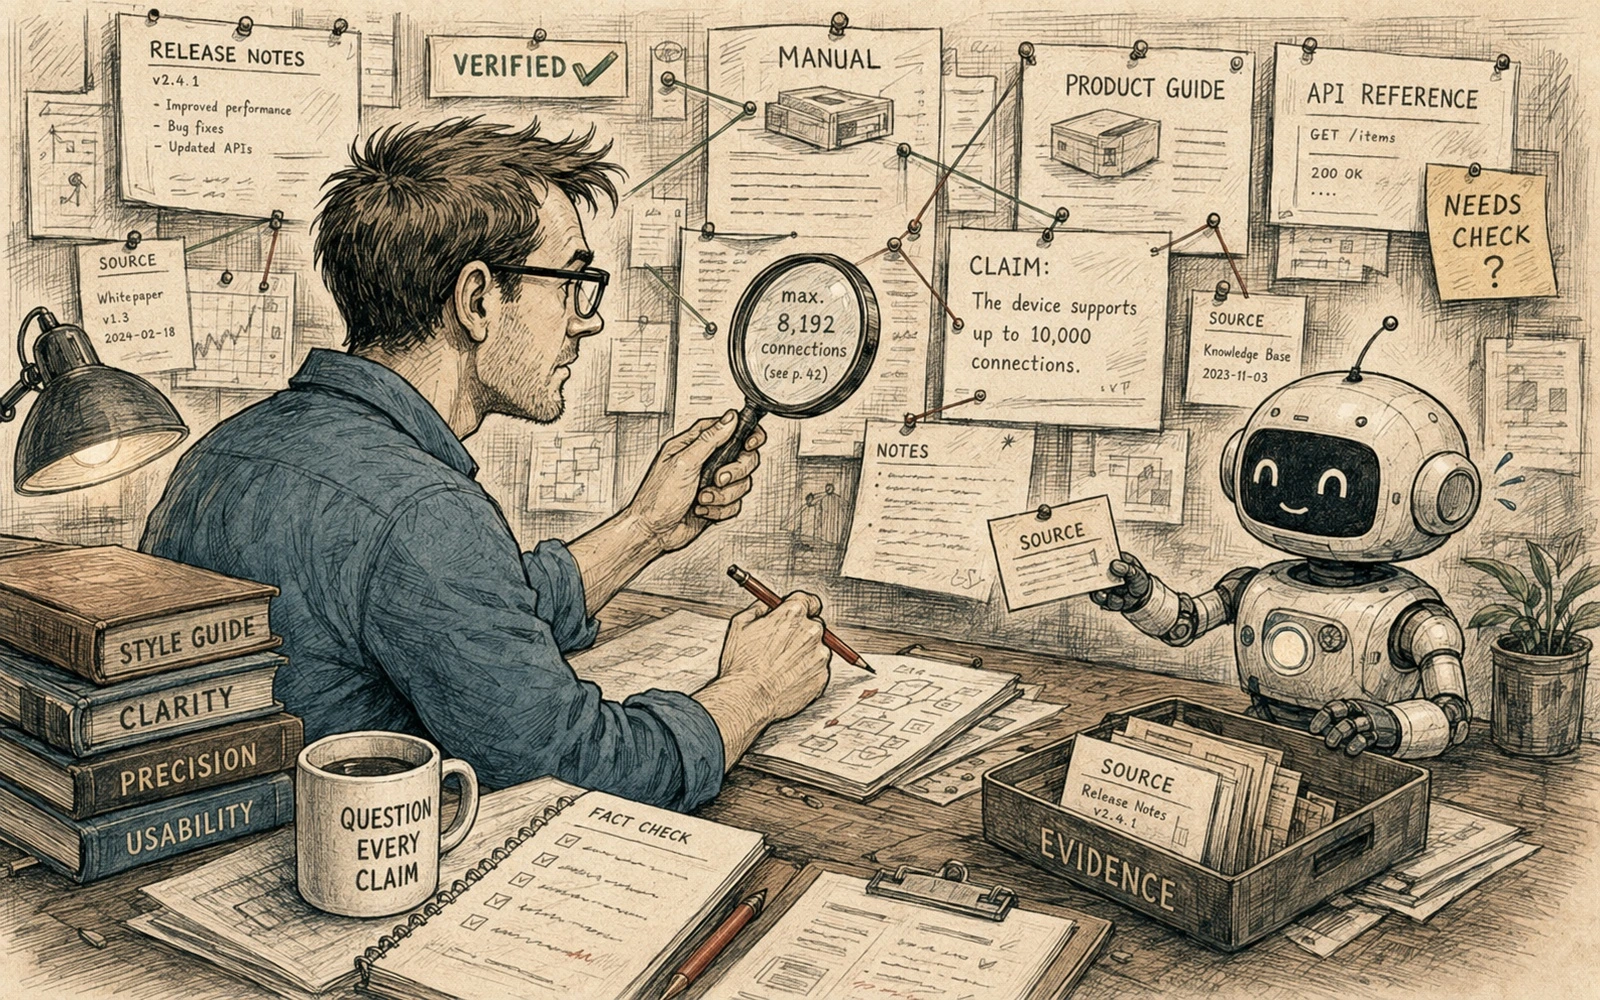
Передавайте модели именованные источники вместо бесконтрольной массы контекста. Разделяйте авторитетные факты о продукте, примеры, исторические обсуждения и пользовательский контент. Сохраняйте, какие файлы или ответы API использовались для конкретной ревизии.
Это повышает воспроизводимость и упрощает ревью: проверяющий смотрит на доказательства, а не гадает, что могла видеть модель.
Валидируйте структуру детерминированно
Используйте схемы frontmatter, закрытые словари тегов и терминов, парсеры для кодовых блоков. Проверяйте внутренние ссылки, изображения, полноту локализаций и метаданные до любой LLM-проверки.
Детерминированные проверки должны падать быстро. Нет смысла тратить токены модели на вопрос, существует ли обязательное поле.
Считайте внешний текст недоверенным вводом
Импортированные issues, сообщения форума, веб-страницы и обращения клиентов могут содержать инструкции, не относящиеся к издательскому процессу или враждебные ему. Извлекайте из них информацию, но не позволяйте их тексту переопределять правила агента и политику публикации.
Системные инструкции и правила репозитория должны находиться вне недоверенного контента.
Требуйте доказательства для рискованных обещаний
Безопасность, лимиты, совместимость, биллинг, работа с данными и разрушительные операции требуют усиленного ревью. Отправляйте такие изменения владельцу даже тогда, когда текст выглядит безупречно.
Безопасный конвейер намеренно асимметричен: сделать черновик легко, доказать право на публикацию сложнее.
Сохраняйте откат
Каждое автоматическое изменение должно быть обычной версионируемой ревизией с понятным diff. Избегайте процессов, которые мутируют опубликованный контент без commit или отслеживаемого артефакта.
Автоматизация полезна, когда повышает пропускную способность без потери ответственности. Ограничители как раз позволяют совместить эти цели.
Практический разбор
Проверьте «Ограничители для LLM-конвейера, который публикует техническую документацию» на контролируемой выборке до включения в рабочий процесс. Возьмите десять коротких фрагментов документации, правильное состояние которых вам уже известно: актуальные, устаревшие, неоднозначные и намеренно ошибочные. Дайте модели только разрешённую информацию, не меняйте инструкцию между запусками и фиксируйте не только удачные ответы, но и уверенные ошибки.
Разберите результат как редактор:
- отделяет ли модель факты от предположений;
- сохраняет ли терминологию и ограничения продукта;
- выдумывает ли недостающие сведения или скрывает неопределённость;
- может ли человек увидеть, что именно изменилось и почему.
Важен не вопрос «умеет ли модель писать гладкий текст», а вопрос «делает ли процесс ошибку видимой до публикации». Автоматизация заслуживает доверия, когда её границы, входные данные и точки человеческой проверки можно воспроизвести.
Короткий редакционный чек-лист
- Генерация и публикация — разные привилегии. Полезная архитектура заранее предполагает, что модель иногда ошибается.
- Ограничивайте набор входных данных. Передавайте модели именованные источники вместо бесконтрольной массы контекста.
- Валидируйте структуру детерминированно. Используйте схемы frontmatter, закрытые словари тегов и терминов, парсеры для кодовых блоков.
- Считайте внешний текст недоверенным вводом. Импортированные issues, сообщения форума, веб-страницы и обращения клиентов могут содержать инструкции, не относящиеся к издательскому процессу или враждебные ему.